
Integrating Apache Spark with ClickHouse - ClickHouse Documentation
Apache Spark is a multi-language engine for executing data engineering, data science, and machine learning on single-node machines or clusters.There are two main ways to connect Apache Spark and Click House: Spark Connector - The Spark connector implements the Data SourceV2 and has its own Catalog management.
 DataStore Query building - ClickHouse DocumentationClickhouse
SQL reference - ClickHouse DocumentationClickhouse
 Redirects - MintlifyMintlify
 Breaking down common documentation mistakesMintlify
 Mintlify Alternatives: What to Consider (and Why There's No True Substitute)Mintlify
 Format text - MintlifyMintlify
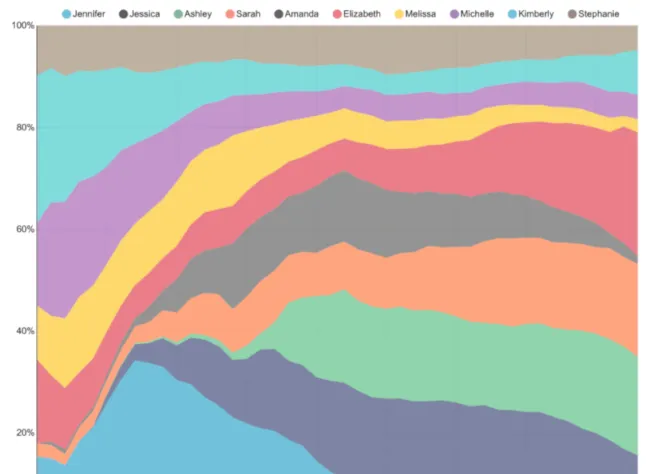 Explore and Visualize Data the Apache Superset WayThenewstack
 CLI ReferenceModal
 skill.md - MintlifyMintlify
 AsyncAPI setup - MintlifyMintlify
 Best Documentation Platforms for AI Agents in 2026Mintlify
 Best Docusaurus Alternatives in 2026Mintlify
 GitHub - MintlifyMintlify
 Autogenerating API documentation from OpenAPIMintlify
 Preview locally - MintlifyMintlify
 API docs with Git integration: best platforms and workflows in 2026Mintlify
